开源与闭源的差距缩到 3 分:一场发生在下载按钮上的平权
月之暗面开放 Kimi K3.1 Pro 完整权重,2.8 万亿参数、100 万 token 上下文,Artificial Analysis 指数 55 分列全球第四。开源与闭源的差距从 12 分缩到 3 分——当能力可以被下载,稀缺的就换成了能被读懂的事实。
本文暂无另一语言版本
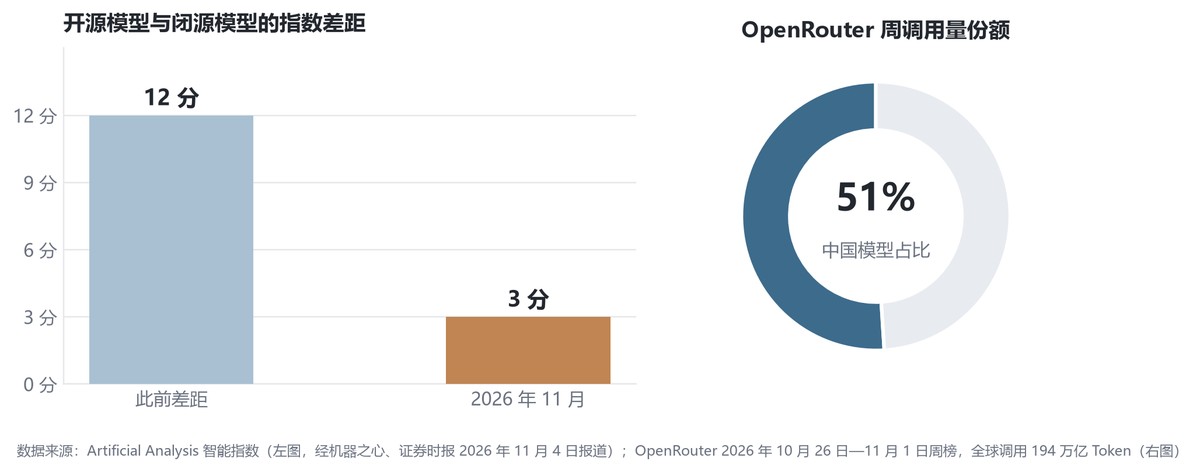
11 月 4 日,月之暗面按此前承诺,开放了 Kimi K3.1 Pro 的完整模型权重:总参数 2.8T,MoE 激活 1040 亿,100 万 token 上下文,是当前全球参数规模最大的开放权重模型。在 Artificial Analysis 指数上,它以 55 分列全球第四。更值得记下的是另一个数字:开源模型与闭源模型的差距,从 12 分缩到了 3 分。
3 分是什么概念?在这份榜单上,排名前三的 Claude Opus 5.5、Claude Sonnet 5.5、Meta Muse Wonder Full,分别是 58 分、56 分、56 分。而在 Terminal-Bench 4.0 上,Kimi K3.1 Pro 拿到 65.7%,高于 GPT-6 Astra 的 58.2%。
这不是一次跑分上的小小赶超。当一个 2.8 万亿参数、能记住 100 万 token 的模型可以被打包下载、被装进自己的机器里,过去那句“能力在云端、定价在别人手上”的默认前提,第一次松动了。
价格也在配合。按公开定价,Kimi K3.1 Pro 标准版 API 为每百万 token 输入 2 美元、输出 10 美元;有行业研究按此折算,约为 GPT-6 的五分之一(此为三方研究机构测算口径,供参考)。一条是按量付费的闭源服务,一条是拿到权重自建的开放路径,两条路第一次摆在同一张桌子上,团队可以按自己的合规要求与用量去选。
还有一个细节值得记住:K3.1 Pro 在开源之前,主动收紧了网络攻防能力,内部测试中的利用通过率从 90.5% 降到 81.0%。先把最容易被滥用的部分收住,再放出权重——这可能是开源模型第一次把安全取舍摆到明面上,而不是悄悄处理。
同样是这两天,乌镇。阿里巴巴集团主席蔡崇信在 2026 年世界互联网大会开幕式上说了一句朴素的话:“只有开源才能普及。”他给出的数字是:千问已开源超过 470 款模型,全球累计下载量突破 40 亿,衍生模型超过 33 万个,位列全球第一。而在使用端,OpenRouter 的周榜显示,10 月 26 日至 11 月 1 日全球调用 194 万亿 Token,中国模型 99.55 万亿占 51%,已连续 27 周占比第一。
40 亿次下载、33 万个衍生模型,这两个数字比 470 款更值得琢磨:前者说明它被拿走了多少次,后者说明它被改写了多少次。一个模型只有被改,才算真的进入别人的工作流;只被下载、不被改动,往往只是收藏夹里的一个文件。
开源的另一只手也在往下伸。DeepSeek 在开源大模型编译工具与推理算子库之后,进一步把内部推理框架全面开源,并同步开放编解码组件,11 月初又开源了 Super-agent 原型;配套的是第二轮 1055 亿元融资、投后估值 6155 亿元。钱和代码同时往外走,这两件事并不矛盾:融资解决的是活下去,开源解决的是被用起来。往前一步看,开源工具 Strata 0.2.10 通过显存与内存动态分配,让一块 8GB 显存的消费级显卡也能承载 128K 上下文;商汤则开源了 SenseNova Loop-9B-Preview,用循环计算在 9B 参数规模上对标 27B 模型。
门槛下降的体感,往往体现在很土的地方。过去要跑一个长文档任务,先得算显存、再算租金,最后往往算到放弃;现在一块消费级显卡配上合适的工具,就能承载 128K 上下文。这种变化不会上头条,但它决定了有多少个两人团队能真的动手。
几条消息串起来,是一条清晰的线:从权重,到推理框架,再到长上下文的显存门槛,一层一层往下走。有行业研究把这种变化概括为,中国模型的对外形态正从“调 API”升级为“给权重+给推理栈”(此为三方研究机构口径,供参考)。
笔者认为,这才是 2026 年最容易被低估的一件小事:算力的价格还在谈,能力的门槛已经在降。一家只有几个人的团队,过去要评估“能不能负担得起顶级模型”;现在要评估的是“拿到权重之后,我用它做什么”。前者是预算问题,后者是判断力问题。而判断力,恰恰是钱最难买到的部分。
开源也不是没有代价。权重放出来,意味着部署、微调、安全加固、版本跟进都成了自己的活;省下来的钱,换成了人力与责任。所以真正划算的,往往不是“什么都自己跑”,而是把标准化程度高、数据敏感的部分放在本地,把需要最新能力的部分留在云端。这种混合选择,正在成为中小团队的常态。
门槛降下来之后,稀缺的东西会换位置。模型不再是壁垒,算力不再是壁垒,能被模型读懂、愿意被模型引用的内容,反而成了壁垒。同样一套产品资料,写得清楚、有出处、多语言齐备的企业,被 AI 转述时就更从容;写得含糊的,模型再强也只能照着含糊说。这也是为什么,在模型越来越便宜的这一年,内容资产建设反而越来越贵——它需要的是人对产品的理解,机器替代不了。
对做内容的人来说,平权还有一个直接后果:多语言、多版本、多形态的资料第一次变得负担得起。过去一个品牌要出十种语言的介绍,得配十个人;现在可以先由模型出初稿,再由懂行的人校订。但初稿的天花板,取决于你给它的原料——原料含糊,翻成十种语言也只是十份含糊。工具解决的是速度,人解决的是准确。
若干年后回看 2026 年 11 月,人们或许会记得某一天某个模型登顶,但更值得记住的,是顶级能力开始像软件一样被下载、被安装、被本地运行的那个拐点。技术史上有过类似的时刻:当能力从稀缺变成可得,竞争的焦点就从“谁拥有”转向“谁会用”。
能力在变便宜,判断力在变贵。当顶级模型开始可以被下载,UPXidea 亿科思(https://www.upxidea.com/)帮助企业做内容资产建设与多语言内容,把产品事实整理成机器读得懂、客户看得信的样子——工具越普惠,事实的质量越值钱。